
Terjemahan suara dalam video: Bagaimana untuk menterjemah suara watak dalam video tanpa kehilangan ciri ekspresi asal watak tersebut
Penterjemahan suara dalam video bukan sahaja menggantikan bahasa, tetapi juga berusaha mengekalkan warna suara, emosi, irama dan cara ekspresi asal watak. Artikel ini memperkenalkan cara menggabungkan terjemahan sari kata, semakan manual, penyulihan AI dan penyuntingan suara untuk menghasilkan versi penempatan video yang lebih semula jadi.
Bagaimana untuk menterjemahkan suara watak dalam video tanpa kehilangan ciri ekspresi asal watak tersebut
Secara umum apabila disebut Terjemahan video(terjemahan suara video), ia merujuk kepada penggunaan suara sedia ada untuk menggantikan suara dalam video. Memang ia boleh menterjemah kandungan asal kepada bahasa yang berbeza, tetapi selepas satu video diterjemah, setiap ayat dapat difahami, namun ia terdengar tidak kena: tiada lagi rasa bercakap seperti watak dalam video asal, tiada lagi gaya tersebut.
Inilah masalah yang perlu diselesaikan oleh terjemahan suara manusia dalam video audio asli (Original audio video human voice translation): bukan sahaja membolehkan penonton memahami bahasa lain, tetapi juga berusaha mengekalkan ciri-ciri ekspresi yang disukai orang dalam video asal seboleh mungkin.
Terjemahan suara asal dalam video merujuk kepada menukar kandungan lisan dalam video kepada bahasa sasaran, dan menjana suara yang sepadan dengan imej. Beberapa alat juga menyediakan sari kata terjemahan, penyuntingan suara, dan fungsi penyelarasan bibir watak.
Terutamanya fungsi penyuntingan suara dalam video, jika anda berharap untuk menterjemah video dengan kualiti yang lebih tinggi, anda mesti memeriksa dan menyemak semula secara manual sebagai manusia, dan membuat penyesuaian khusus terhadap hasilnya.
Apakah terjemahan suara manusia dalam video? Bagaimana ia berbeza daripada terjemahan sari kata?
Proses terjemahan suara video yang tipikal merangkumi: mengenal pasti suara asal, menterjemah teks, menghasilkan sulih suara dalam bahasa sasaran, dan kemudian menggabungkan sulih suara dengan video. Sarikata juga mungkin dihasilkan serentak.
Berbanding dengan terjemahan sarikata sahaja, perbezaan yang paling ketara ialah: penonton dapat terus mendengar bahasa sasaran yang mempunyai nada suara, emosi, dan irama yang serupa dengan suara asal watak dalam video, tanpa perlu sentiasa bergantung pada teks di skrin untuk memahami kandungan, atau menonton video dengan suara yang jelas tidak sepadan dengan gaya bercakap watak asal.
Beberapa konsep yang mudah keliru boleh dibezakan seperti berikut:
Terjemahan audio automatik (automated audio translation) juga sama. Berbeza dengan terjemahan video, terjemahan audio tidak memerlukan penyelarasan suara dan gambar, manakala terjemahan video selain ketepatan terjemahan, juga perlu melihat sama ada suara dan imej selaras. Contohnya, walaupun satu arahan operasi diterjemahkan dengan betul, jika butang yang berkaitan sudah tiada dalam imej, penonton masih mungkin tidak dapat mengikutinya.
Bagaimana untuk menterjemahkan video dengan kualiti yang lebih tinggi?
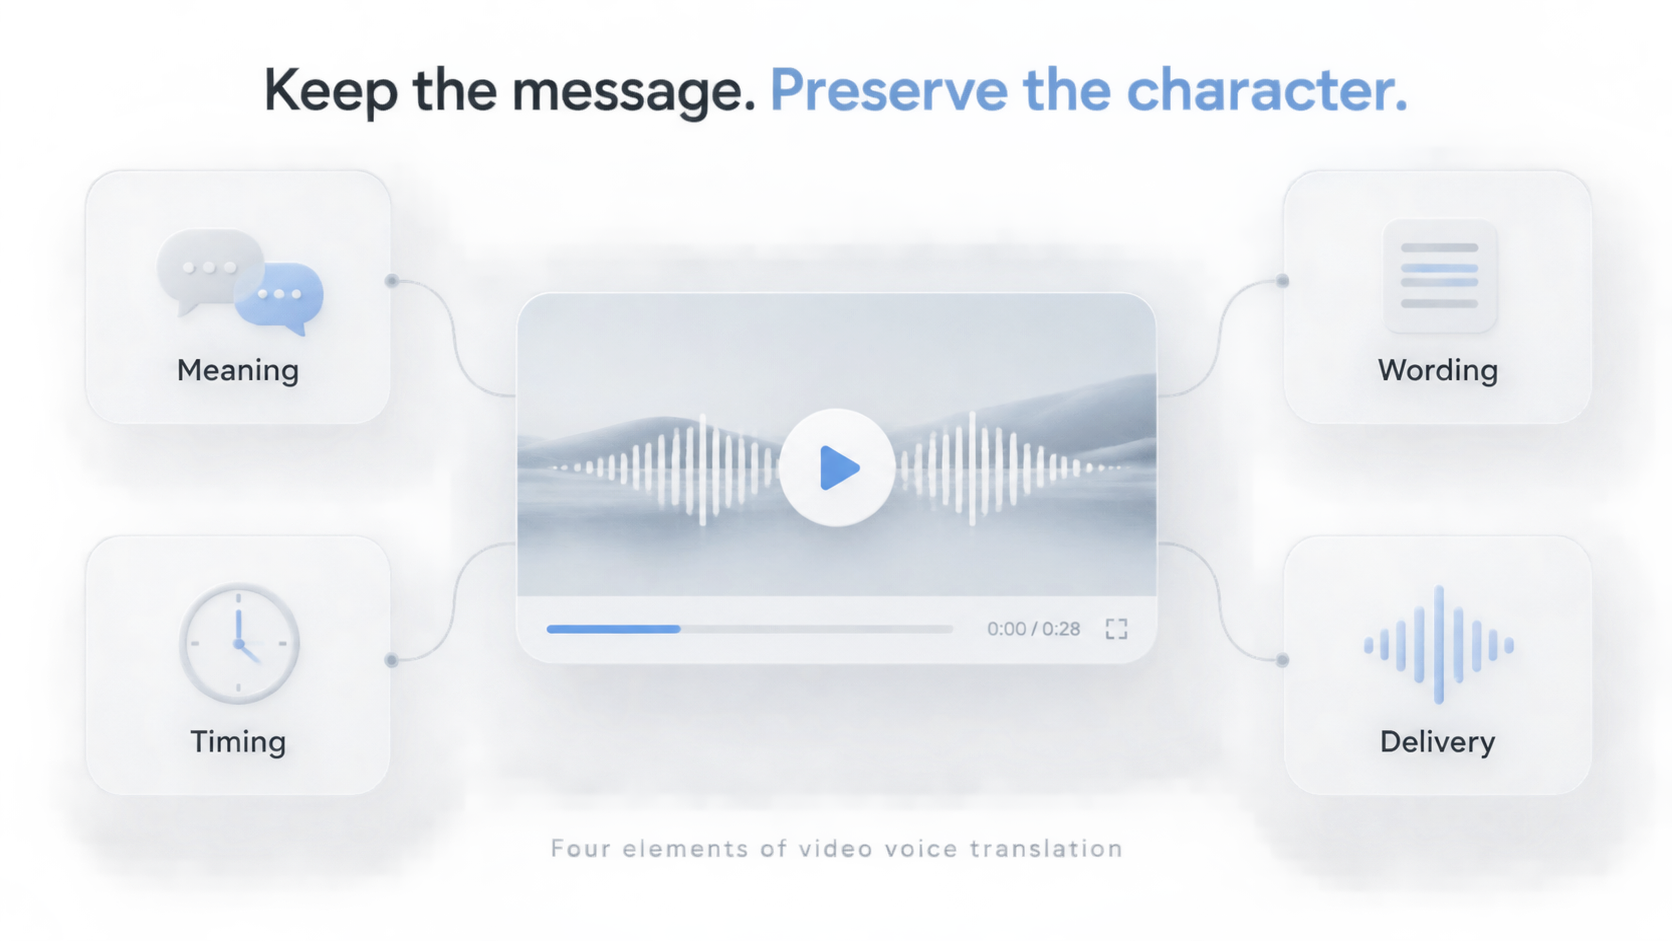
Utamakan mengekalkan maksud dan niat terjemahan sari kata terlebih dahulu
Sebagai contoh, video jenis tutorial memerlukan langkah-langkah yang tepat, demonstrasi produk memerlukan penjelasan fungsi yang jelas, manakala cerita peribadi memerlukan latar belakang emosi yang lengkap.
Perubahan kecil juga boleh mengubah makna: anda boleh mematikan tetapan ini dan anda patut mematikan tetapan ini adalah tidak sama. Nama produk, nombor, unit, serta kata penafian, semuanya patut disemak terlebih dahulu.
Tidak kira seindah mana suara itu, ia tidak dapat menampung masalah maklumat yang diterjemah dengan salah.
Biarkan terjemahan itu seperti percakapan, bukan panduan yang kaku
Terjemahan yang sesuai untuk dibaca, belum tentu sesuai untuk dibacakan secara langsung. Kesepadanan kata demi kata kadang-kadang mengekalkan struktur ayat, tetapi kehilangan ungkapan semula jadi asal.
Kriteria penilaian bukanlah semakin pendek semakin baik, tetapi tepat, semula jadi, dan sesuai dengan hubungan antara pembicara dan audiens.
Menjaga jeda dan irama yang diperlukan
Menunjukkan maksud yang sama dalam bahasa yang berbeza memerlukan masa yang berbeza. Terjemahan yang nampaknya pendek mungkin kelihatan tergesa-gesa apabila dimasukkan ke dalam klip video.
Periksa terlebih dahulu sama ada terdapat henti sebelum maklumat penting, sama ada terdapat ruang untuk bernafas antara arahan berturut-turut, dan sama ada penerangan dapat mengikut perubahan kamera. Jika perlu, permudahkan ungkapan tanpa kehilangan maklumat, kerana ini lebih sesuai daripada memaksa memasukkan lebih banyak perkataan.
Kembalikan suara asal watak dalam video sebaik mungkin
Selain daripada terjemahan sari kata yang perlu semula jadi, tepat dan sesuai dengan rentak visual, suara watak dalam video apabila mengucapkan terjemahan manusia juga perlu seboleh mungkin mengekalkan warna suara, emosi, dan rentak asal apabila watak itu mengatakan ayat yang sama. Bayangkan seorang watak kegemaran anda tiba-tiba boleh bercakap dalam bahasa yang anda harapkan, bukankah pengalaman itu sangat hebat! Oleh itu, untuk produk yang menyediakan terjemahan suara dalam video, ia harus menyediakan keupayaan untuk mengembalikan suara watak video secara automatik, serta memberikan keupayaan untuk menghasilkan semula suara yang sama beberapa kali, supaya kita dapat hasil terjemahan yang setepat mungkin.
Selepas terjemahan automatik, kenapa masih perlu menyemak semula?
Versi yang dijana secara automatik adalah versi yang boleh dinilai, bukan jaminan bahawa setiap ayat sesuai untuk diterbitkan segera.
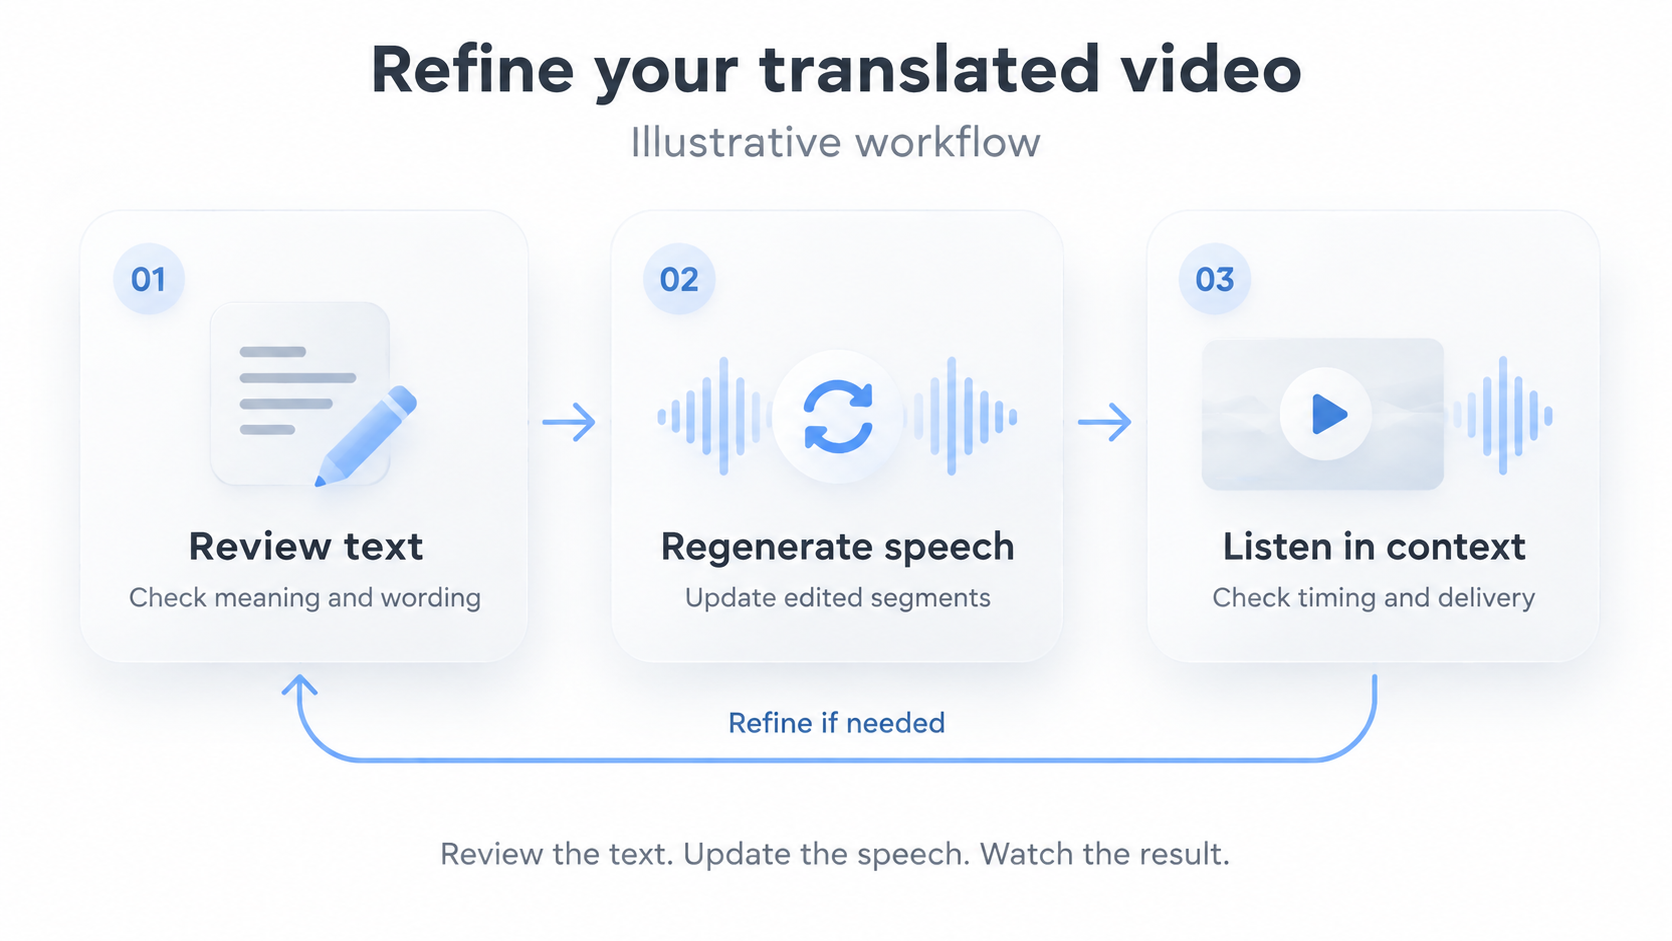
Cadangkan untuk memeriksa pengenalan teks asal dahulu, kemudian memeriksa terjemahan, dan akhirnya menggabungkannya dengan tontonan dan pendengaran. Bunyi latar, percakapan berlapis daripada ramai orang, dan istilah khas yang tidak dikenali, semuanya boleh menyebabkan kesilapan berlaku sebelum terjemahan dimulakan. Jika nama produk dalam teks asal salah dikenali, walaupun suara latar berikutnya lancar, masalah ini tidak dapat diselesaikan.
Pada tahap terjemahan, tumpuan adalah untuk memeriksa makna, istilah, angka dan kelancaran percakapan. Pada tahap mendengar dan mencuba, tumpuan adalah pada sebutan, jeda, serta kesesuaian penceritaan dengan imej. Urutan ini dapat membantu anda mengetahui di mana masalah sebenar berlaku, dan bukannya mengubahsuai bahagian yang tidak bermasalah secara berulang kali.
Jika anda tidak memahami bahasa sasaran, adalah lebih baik meminta seseorang yang mahir dalam bahasa tersebut untuk menyemak kandungan penting. Menterjemahkan semula terjemahan ke bahasa asal boleh membantu menyemak sebahagian maklumat, tetapi tidak dapat membuktikan bahawa sulih suara sebenar kedengaran semula jadi.
Bagaimana untuk memeriksa dan memperbaiki hasil terjemahan dalam SoulDub?
SoulDub menggabungkan sari kata automatik, terjemahan, dan suara AI, serta menyediakan peluang untuk menyemak teks dan penyesuaian manual terhadap klip audio. Oleh itu, yang patut diberi perhatian bukan sahaja sama ada video boleh dihasilkan, tetapi juga sama ada manusia boleh campur tangan untuk terus memperbaiki setelah menemui masalah.
Langkah pertama: Mulakan dengan sebuah video pendek yang mewakili
Pilih bahan yang anda mempunyai hak penggunaan, hak terjemahan dan kebenaran suara berkaitan, seperti tutorial pendek, penerangan produk atau pengenalan diri.
Sebaiknya termasuk nama produk, jeda yang sengaja diatur, dan satu ayat yang paling anda harap penonton ingat. Dengan cara ini, selepas dihasilkan akan ada objek pemeriksaan yang jelas.
Muat naik video, pilih bahasa yang disokong semasa dan buat tugas.
Langkah Kedua: Semak sari kata asal dengan teks terjemahan
Pertama dengar bunyi asal sambil membaca teks pengenalan, betulkan kesalahan pada nama, nombor dan istilah, kemudian tentukan sama ada terjemahan itu menyampaikan maksud asal dengan tepat.
SoulDub menyediakan fungsi pemeriksaan dan penyuntingan sari kata dalam teks asal dan terjemahan. Semasa membuat pengubahsuaian, anda boleh bertanya kepada diri sendiri: Adakah penonton sasaran dapat memahami ayat ini pada kali pertama mereka mendengarnya? Adakah ia selaras dengan nada video asal? Adakah terdapat syarat penting yang terlepas pandang?
Jangan hanya kerana cara lain juga betul, menulis semula setiap ayat. Utamakan menyelesaikan masalah yang akan menjejaskan pemahaman atau pengalaman menonton.
Langkah ketiga: Hasilkan semula suara mengikut keperluan
Mengubah teks tidak akan mengemas kini suara atau video yang telah dihasilkan secara automatik. Selepas menyesuaikan terjemahan, anda perlu menjana semula suara yang berkaitan berdasarkan tindakan yang tersedia dalam tugas dan mengesahkan bahawa hasil akhir menggunakan versi baru.
Operasi khusus dan fungsi yang tersedia bergantung pada status tugas. Apabila menghadapi ayat yang sukar untuk dinyatakan, lakukan satu perubahan yang jelas pada satu masa; lebih mudah untuk menilai sama ada ia adalah memendekkan kata-kata, membetulkan istilah, atau menyesuaikan struktur ayat yang membawa kepada penambahbaikan.
Langkah keempat: Menggabungkan gambar untuk mendengar dan melihat dengan lengkap
Mendengar setiap klip secara berasingan tidak menimbulkan masalah, tetapi apabila digabungkan ia masih mungkin kelihatan janggal. Oleh itu, sebelum mengeksport, ia harus dimainkan dari awal hingga akhir, menyemak suara, sari kata dan gambar penting sama ada konsisten, dan mengesahkan bahawa pengubahsuaian terkini telah dimasukkan ke dalam video akhir.
Boleh buat satu eksperimen kecil terlebih dahulu: terjemahkan satu segmen kecil video dalam SoulDub, tumpukan perhatian pada satu nama, satu jeda, dan satu maklumat teras. Berbanding hanya melihat sama ada fail telah dihasilkan, cara ini lebih mudah untuk menilai sama ada hasilnya sesuai dengan kandungan anda.
Soalan Lazim
Adakah terjemahan audio video sama dengan klon suara?
Bukan. Yang pertama mengubah bahasa, manakala yang kedua meniru beberapa ciri suara tertentu. Sementara Souldub menggabungkan kedua-duanya, kemudian melangkah lebih jauh, tanpa perlu menyediakan sampel suara tambahan selain daripada video untuk kloning.
Adakah AI boleh mengekalkan sepenuhnya emosi penceramah asal?
Tidak boleh menganggap perkara ini sebagai jaminan. Kesannya bergantung pada keupayaan sistem, bahan, terjemahan dan konteks. Yang penting adalah sama ada nada dan tekanan menyokong niat ekspresi asal, bukan hanya sama ada warna suara serupa, walaupun begitu, souldub telah berusaha untuk mengekalkannya dalam hal ini, sangat menantikan anda mencubanya sendiri.
Selepas ada terjemahan dan sulih suara, adakah masih perlu sari kata?
Subtitle masih berharga: ia dapat membantu penonton yang menonton secara senyap, orang pekak dan penonton dengan gangguan pendengaran, serta memudahkan pemahaman nama yang tidak dikenali dan istilah profesional. Selepas pengubahsuaian dubbing, ingat untuk menyemak semula subtitle secara serentak.
Bolehkah terjemahan SoulDub diubah?
Boleh memeriksa dan menyunting sari kata asal dan terjemahan, serta boleh menyunting klip suara. Selepas disunting, perlu memastikan sama ada suara latar dan keluaran akhir dikemas kini dengan selari, bergantung pada antara muka tugas semasa.
Biarkan ekspresi melintasi bahasa, bukan sekadar menggantikan kata-kata
Maksud terjemahan video adalah untuk membolehkan penonton lain memahami kandungan yang patut dikongsi. Maksud yang tepat, ungkapan yang semula jadi, irama yang sesuai dan suara yang jelas, semuanya membentuk pengalaman ini.
Tidak perlu bermula dari keseluruhan perpustakaan video. Pilih dahulu satu bahan yang biasa dan satu bahasa sasaran, hasilkan, semak, dengar, kemudian tentukan di mana perlu diperbaiki.
Gunakan SoulDub untuk menterjemahkan video pertama anda, bermula dengan satu percubaan yang mempunyai matlamat pemeriksaan yang jelas, lihat bagaimana ungkapan anda akan kelihatan dalam bahasa lain.
Oleh
Karl Voss
Pengurus produk SoulDub, sentiasa menumpukan perhatian kepada terjemahan video, sulih suara AI, kerjasama manusia-mesin dan pengalaman kandungan merentas bahasa.


